Ранее в посте Задача двух осей и четырех графиков - игра с matplotlib
я рассмотрел разбиени холста на области и рисование нескольких графиков.
Пойдем дальше - рассмотим всякие подписи и для начала подпишем оси и графики

01 July 2020
Панда - обновляем CSV на облачном файловом хранилище
Чисто интресно было проверить - меняется ли ссылка при обновлении файла ?
Т.е. скажем мы обновили данные и пытаемся обновить файл на облаке, выбрав его замену.
Как показал эксперимент - не меняется. И на google drive и на яндекс-диске.
Т.е. смело можно обновлять и читать питоном уже имеющуюся ссылку.
Чисто для себя - если требуется вывести последние несколько строк, можно использовать отрицательную индексацию, типа такого
df[-7:]
Данная строчка выведет последние семь строчек фрейма Панды. Т.е. от минус семи до конца.
Т.е. скажем мы обновили данные и пытаемся обновить файл на облаке, выбрав его замену.
Как показал эксперимент - не меняется. И на google drive и на яндекс-диске.
Т.е. смело можно обновлять и читать питоном уже имеющуюся ссылку.
Чисто для себя - если требуется вывести последние несколько строк, можно использовать отрицательную индексацию, типа такого
df[-7:]
Данная строчка выведет последние семь строчек фрейма Панды. Т.е. от минус семи до конца.
29 June 2020
Панда - открываем CSV с Google Drive
Ранее я рассмотрел пример открытия файла CSV с яндекс-диска - Панда - открываем CSV c яндекс-диска
Подобным же способом его можно открыть и с Гугл-диска.
Путь к файлу у Гугл длиннее и выглядит подобным образом:
https://drive.google.com/file/d/xxxx123457yyyZZyZyZxxx_xYxYxxx_4x/view?usp=sharing
Нам потребуются те же самые импорты, но код будет несколько другим в части обработки адреса:
# задаем адрес нашего загруженного файла
addr = 'https://drive.google.com/file/d/xxxx123457yyyZZyZyZxxx_xYxYxxx_4x/view?usp=sharing'
# формируем путь для загрузки
path = 'https://drive.google.com/uc?export=download&id='+addr.split('/')[-2]
# в path теперь будет что-то типа такого
# https://drive.google.com/uc?export=download&
# id=xxxx123457yyyZZyZyZxxx_xYxYxxx_4x
Далее действуем как в случае яндекс-диска:
download_response = requests.get(path)
csv_raw = StringIO( download_response.content.decode('cp866'))
df = pd.read_csv(csv_raw, sep=';')
В результате данные загружены.
Подобным же способом его можно открыть и с Гугл-диска.
Путь к файлу у Гугл длиннее и выглядит подобным образом:
https://drive.google.com/file/d/xxxx123457yyyZZyZyZxxx_xYxYxxx_4x/view?usp=sharing
Нам потребуются те же самые импорты, но код будет несколько другим в части обработки адреса:
# задаем адрес нашего загруженного файла
addr = 'https://drive.google.com/file/d/xxxx123457yyyZZyZyZxxx_xYxYxxx_4x/view?usp=sharing'
# формируем путь для загрузки
path = 'https://drive.google.com/uc?export=download&id='+addr.split('/')[-2]
# в path теперь будет что-то типа такого
# https://drive.google.com/uc?export=download&
# id=xxxx123457yyyZZyZyZxxx_xYxYxxx_4x
Далее действуем как в случае яндекс-диска:
download_response = requests.get(path)
csv_raw = StringIO( download_response.content.decode('cp866'))
df = pd.read_csv(csv_raw, sep=';')
В результате данные загружены.
28 June 2020
Задача двух осей и четырех графиков - игра с matplotlib
В посте выше Задача двух осей и четырех графиков - введение мы посмотрели как сделать модельные данные.
Давайте теперь поиграем с библиотекой при рисовании.
Пусть нам надо сделать два графика, по два набора данных.
Однако такой простой код тут нам не поможет:
# рисуем x,y реальные и модельные, причем для модельный точками зеленого цвета
# 'go' - первая буква от green, вторая - кружочки
plt.plot( x,y , x,yr ,'go')
# рисуем x,y2 реальные и модельные, причем для модельный точками синего цвета
plt.plot( x,y2 , x,yr2 ,'bo')
Как можно видеть - задача не достигнута и все нарисовалось на одном графике.

Поэтому в данном случае имеет смысл разбить холст на области.
В терминологии matplotlib то, что я называю холст - это figure - объект-контейнер самого высокого уровня. Соответственно область - это axes, которая создается вызовом subplot или subplots.
Проще в использовании subplot, которые принимает на вход три цифры через запятую или одну трехзначную цифру и позволяет создать область.
Вот новый код:
# создаем первую область:
# первая 2 - количество областей по вертикали (rows)
# вторая 1 - количество областей по горизонтали (cols)
# третья 1 - индекс - первая область
plt.subplot(211)
plt.plot( x,y , x,yr ,'go')
# создаем вторую область с индексом 2 соответственно
plt.subplot(212)
plt.plot( x,y2 , x,yr2 ,'bo')
Теперь мы получили уже то, что надо

Второй способ - использовать вызов subplots, который вернет figure и
массив axes:
# создаем области - две по вертикиали в одну колонку
# и запоминаем ссылку на холст(фигуру) и области(оси)
fig, ax = plt.subplots(2,1)
# рисуем первый график в первой области
ax[0].plot( x,y , x,yr ,'go')
# рисуем второй график во второй области
ax[1].plot( x,y2 , x,yr2 ,'bo')
Этот код нарисует в точности такой же рисунок как и выше.
Давайте теперь поиграем с библиотекой при рисовании.
Пусть нам надо сделать два графика, по два набора данных.
Однако такой простой код тут нам не поможет:
# рисуем x,y реальные и модельные, причем для модельный точками зеленого цвета
# 'go' - первая буква от green, вторая - кружочки
plt.plot( x,y , x,yr ,'go')
# рисуем x,y2 реальные и модельные, причем для модельный точками синего цвета
plt.plot( x,y2 , x,yr2 ,'bo')
Как можно видеть - задача не достигнута и все нарисовалось на одном графике.

Поэтому в данном случае имеет смысл разбить холст на области.
В терминологии matplotlib то, что я называю холст - это figure - объект-контейнер самого высокого уровня. Соответственно область - это axes, которая создается вызовом subplot или subplots.
Проще в использовании subplot, которые принимает на вход три цифры через запятую или одну трехзначную цифру и позволяет создать область.
Вот новый код:
# создаем первую область:
# первая 2 - количество областей по вертикали (rows)
# вторая 1 - количество областей по горизонтали (cols)
# третья 1 - индекс - первая область
plt.subplot(211)
plt.plot( x,y , x,yr ,'go')
# создаем вторую область с индексом 2 соответственно
plt.subplot(212)
plt.plot( x,y2 , x,yr2 ,'bo')
Теперь мы получили уже то, что надо

Второй способ - использовать вызов subplots, который вернет figure и
массив axes:
# создаем области - две по вертикиали в одну колонку
# и запоминаем ссылку на холст(фигуру) и области(оси)
fig, ax = plt.subplots(2,1)
# рисуем первый график в первой области
ax[0].plot( x,y , x,yr ,'go')
# рисуем второй график во второй области
ax[1].plot( x,y2 , x,yr2 ,'bo')
Этот код нарисует в точности такой же рисунок как и выше.
26 June 2020
Задача двух осей и четырех графиков - введение

Этого, пожалуй, вполне хватит, если речь идет только о моделировании и вот почему:
на графиках, хоть и разный масштаб, но интересна динамика, поэтому даже учитывая малую амплитуду для данных Infected и Death мы тут видим качественное изменение, что вполне достаточно для анализа.
Теперь представим себе другой случай - мы не просто моделируем, но и смотрим соответствие модели экспериментальным данным.
Тогда:
- количество графиков удваивается - надо показывать как модельные так и реальные данные
- масштаб играет роль - насколько модель будет отражать реальные данные для того же графика Death при мелком размере графика будет непонятно.
Для симуляции модельных данных я буду брать модель синуса и косинуса, а для симуляции реальных данных - просто добавлю туда случайные величины.
По факту для работы нам достаточно импортировать только NumPy:
import numpy as np
Данные будут храниться в глобальных переменных. Пусть амплитуды будут различаться.
Пусть ось x будет одинаковая.
Возьмем для примера два набора - y и y2, реальные данные будут тогда yr и yr2 соответственно:
x, y, y2, yr, yr2 = [], [], [], [], []
Теперь сначала вычислим данные для модельных наборов:
# параметры тригонометрический функций
f = 0.5; phase = 2
# 10 значений по оси х
x = np.linspace(0, 10, 10)
# y будет синусом
y = np.sin(f * x + phase)
# y2 будет косинусом с пятикратно более высокой амплитудой
y2 = 5*np.cos(f * x + phase)
Далее смоделируем реальные данные. Вычислять их будем по модельным, используя векторные возможности NumPy:
yr = y + np.random.random() * y
yr2 = y2 + np.random.random() * y2
Т.е. в каждой точке данные получаются умножением случайного числа в диапазоне (0,1) на модельные данные.
Если хочется решить задачу при минимальном кодировании, то логично сделать два графика - для y и для y2:

Если хочется уплотнить информацию - удобнее эти два графика сделать на одном, но с двумя осями.

Второй способ - более тяжелый с точки зрения кодирования, но более компактный: скажем в случае SEIRD модели надо четыре величины и их можно упаковать в два графика.
В дальнейшем мы эти варианты последовательно рассмотрим.
24 June 2020
Панда - открываем CSV c яндекс-диска
Одна из задач, которая возникла у меня - перенос с одного компа с Windows и Excel данные на виртуалку с Убунтой. Чтобы не заморачиваться с копированием файлов можно выложить CSV, полученный из Excel на яндекс-диск и открыть его в Юпитере Пандой.
Ссылка для доступа будет иметь вид примерной такой :
https://yadi.sk/d/xxYYYzzzKKKzY
Для начала экспортируем то, что надо
import pandas as pd
import requests
from io import StringIO
from urllib.parse import urlencode
Далее заводим строчки:
# адрес на api яндекса
base_url = 'https://cloud-api.yandex.net/v1/disk/public/resources/download?'
# Наша ссылка
public_key = 'https://yadi.sk/d/xxYYYzzzKKKzY'
Далее загружаем файл:
# Получаем загрузочную ссылку
final_url = base_url + urlencode(dict(public_key=public_key))
response = requests.get(final_url)
download_url = response.json()['href']
# Загружаем файл и сохраняем его
download_response = requests.get(download_url)
Формально можно записать файл, а потом подать его панде:
with open('temp.csv', 'wb') as f:
f.write(download_response.content)
df = pd.read_csv('temp.csv')
Однако в данном случае Панда вылетит с ошибкой.
Причина тут вот какая: если вы сохраняете файл в CSV формате в Excel то используете MS-DOS CSV и у вас разделитель полей - точка с запятой, а не запятая, как в обычном CSV. Файл, с разделениям точкой с запятой, "умная" Панда читать отказывается.
Поэтому надо ей подсказать разделитель. Вот так:
df = pd.read_csv('temp.csv', sep=';')
Но и это не все - русские символы кодируются в кодировке cp866.
Поэтому если нужно перенести корректно русские данные, надо перекодировать символы в другую кодировку.

Собирая это все вместе и обходясь без промежуточного файла ( он желателен при отладке ), получаем:
# Перекодируем из cp866
csv_raw = StringIO( download_response.content.decode('cp866'))
# Читаем пандой прямо из буфера, подставляя нужный разделитель
df = pd.read_csv(csv_raw, sep=';')
Вот получившиеся данные:

Ответ был подсмотрен тут : как скачивать файлы с яндекс диска
Ссылка для доступа будет иметь вид примерной такой :
https://yadi.sk/d/xxYYYzzzKKKzY
Для начала экспортируем то, что надо
import pandas as pd
import requests
from io import StringIO
from urllib.parse import urlencode
Далее заводим строчки:
# адрес на api яндекса
base_url = 'https://cloud-api.yandex.net/v1/disk/public/resources/download?'
# Наша ссылка
public_key = 'https://yadi.sk/d/xxYYYzzzKKKzY'
Далее загружаем файл:
# Получаем загрузочную ссылку
final_url = base_url + urlencode(dict(public_key=public_key))
response = requests.get(final_url)
download_url = response.json()['href']
# Загружаем файл и сохраняем его
download_response = requests.get(download_url)
Формально можно записать файл, а потом подать его панде:
with open('temp.csv', 'wb') as f:
f.write(download_response.content)
df = pd.read_csv('temp.csv')
Однако в данном случае Панда вылетит с ошибкой.
Причина тут вот какая: если вы сохраняете файл в CSV формате в Excel то используете MS-DOS CSV и у вас разделитель полей - точка с запятой, а не запятая, как в обычном CSV. Файл, с разделениям точкой с запятой, "умная" Панда читать отказывается.
Поэтому надо ей подсказать разделитель. Вот так:
df = pd.read_csv('temp.csv', sep=';')
Но и это не все - русские символы кодируются в кодировке cp866.
Поэтому если нужно перенести корректно русские данные, надо перекодировать символы в другую кодировку.

Собирая это все вместе и обходясь без промежуточного файла ( он желателен при отладке ), получаем:
# Перекодируем из cp866
csv_raw = StringIO( download_response.content.decode('cp866'))
# Читаем пандой прямо из буфера, подставляя нужный разделитель
df = pd.read_csv(csv_raw, sep=';')
Вот получившиеся данные:

Ответ был подсмотрен тут : как скачивать файлы с яндекс диска
20 June 2020
Plotly - задача о двух графиках в Юпитере
В прощлый раз сделать интерактивными два графика, которые рисует matplotlib,как я показал - вовсе не тривиальна - они начинают плодиться.
Посмотрим как это же самое решается посредством библиотеки plotly.
Для начала импортируем нужные библиотеки:
import numpy as np
import ipywidgets as widgets
from IPython.display import clear_output
import plotly.graph_objects as go
from plotly.subplots import make_subplots
Функция вычисления у нас такая же:
x, y, y2 = [], [], []
def calc(f, phase):
global x,y,y2
x = np.linspace(0, 10, 100)
y = np.sin(f * x + phase)
y2 = np.cos(f * x + phase)
А вот графики в plotly создаются по-другому:
# создаем виджет для холста с двумы строками в одну колонку
fv = go.FigureWidget(make_subplots(rows=2, cols=1))
# создаем первый график - для y - он в первой строке
fv.add_trace(
go.Scatter(x=x, y=y, name="yaxis data"),row=1,col=1
)
# создаем второй график - для y2 - он во второй строке
fv.add_trace(
go.Scatter(x=x, y=y2, name="yaxis2 data"),row=2,col=1
)
# Устанавливаем название графика - Double Y Axis Example
fv.update_layout( title_text="Double Y Axis Example" )
# Делаем подпись оси x
# если не запомнить это в безликую переменную "_"
# то после выполнения этой команды
# сразу покажутся два пустых графика
_ =fv.update_xaxes(title_text="xaxis title")
Функция рисования теперь тоже отличается - нам нужно просто присвоить
данные графикам:
def plot_f(f, phase):
global x,y,y2, fv
calc(f, phase)
fv.data[0].x = x
fv.data[0].y = y
fv.data[1].x = x
fv.data[1].y = y2
В данном случае индекс идет по порядку добавления - мы добавили первым
первый график и он идет с индексом 0, а второй - с индексом 1.
Создание виджетов и обработчик кнопки не отличаются от таких же как в примере с matplotlib
И после их выполнения - т.е. выполнения последней строчки создания VBox мы увидим то, что нам нужно:

после того, как движками мы изменим значения и нажмем кнопку, график обновится:
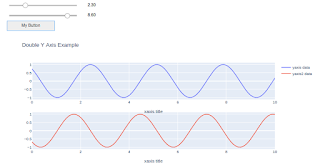
При каждом новом нажатии кнопки график будет обновляться, но не рисоваться дополнительно.
Посмотрим как это же самое решается посредством библиотеки plotly.
Для начала импортируем нужные библиотеки:
import numpy as np
import ipywidgets as widgets
from IPython.display import clear_output
import plotly.graph_objects as go
from plotly.subplots import make_subplots
Функция вычисления у нас такая же:
x, y, y2 = [], [], []
def calc(f, phase):
global x,y,y2
x = np.linspace(0, 10, 100)
y = np.sin(f * x + phase)
y2 = np.cos(f * x + phase)
А вот графики в plotly создаются по-другому:
# создаем виджет для холста с двумы строками в одну колонку
fv = go.FigureWidget(make_subplots(rows=2, cols=1))
# создаем первый график - для y - он в первой строке
fv.add_trace(
go.Scatter(x=x, y=y, name="yaxis data"),row=1,col=1
)
# создаем второй график - для y2 - он во второй строке
fv.add_trace(
go.Scatter(x=x, y=y2, name="yaxis2 data"),row=2,col=1
)
# Устанавливаем название графика - Double Y Axis Example
fv.update_layout( title_text="Double Y Axis Example" )
# Делаем подпись оси x
# если не запомнить это в безликую переменную "_"
# то после выполнения этой команды
# сразу покажутся два пустых графика
_ =fv.update_xaxes(title_text="xaxis title")
Функция рисования теперь тоже отличается - нам нужно просто присвоить
данные графикам:
def plot_f(f, phase):
global x,y,y2, fv
calc(f, phase)
fv.data[0].x = x
fv.data[0].y = y
fv.data[1].x = x
fv.data[1].y = y2
В данном случае индекс идет по порядку добавления - мы добавили первым
первый график и он идет с индексом 0, а второй - с индексом 1.
Создание виджетов и обработчик кнопки не отличаются от таких же как в примере с matplotlib
И после их выполнения - т.е. выполнения последней строчки создания VBox мы увидим то, что нам нужно:

после того, как движками мы изменим значения и нажмем кнопку, график обновится:

При каждом новом нажатии кнопки график будет обновляться, но не рисоваться дополнительно.
Subscribe to:
Posts (Atom)